
Votre IA garde-t-elle un dossier sur vous ? Ce que deviennent vos conversations
Par André Gentit, DeepDive · Publié le 22 octobre 2026 · Lecture : 11 min
TL;DR
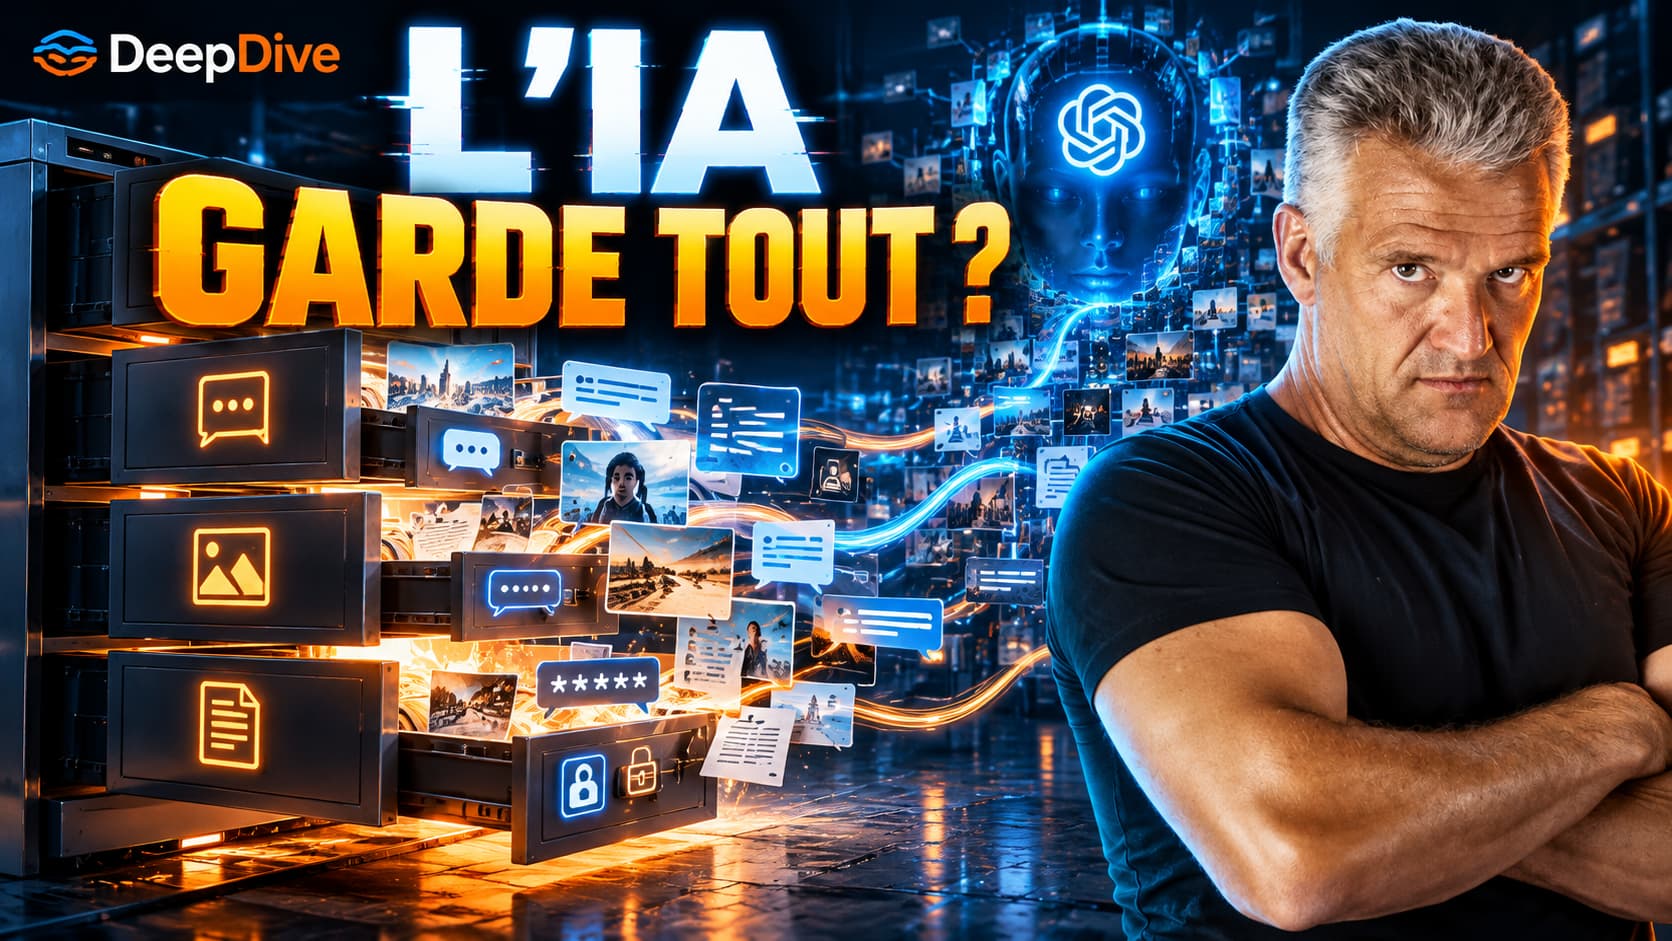
Vous demandez à une IA de reformuler un mail à un salarié. Puis de préparer un entretien tendu. Puis, à 23 h, de vous aider à trouver les mots pour un souci familial. Chaque demande est anodine. Mises bout à bout, elles ressemblent furieusement à un dossier. Personne ne l’a ouvert exprès : c’est le prix de la commodité.
Reste à savoir ce que ce dossier contient, qui peut le lire et combien de temps il survit. Cet article y répond sans catastrophisme (non, vos conversations ne partent pas aux enchères) ni angélisme (non, « privé » ne veut pas dire « confidentiel »). Les exemples sont sourcés, cliquez, vérifiez, c’est le but.
Historique, mémoire, entraînement : trois boutons qu’on confond tous les jours
Une conversation laisse plusieurs traces, et chacune a son propre interrupteur. L’historique, c’est la liste de vos discussions. La mémoire, c’est ce que le service en retire pour personnaliser la suite. L’entraînement, c’est l’éventuelle réutilisation de vos contenus pour améliorer les modèles. Trois sujets, trois réglages, une confusion générale.
La mémoire : un carnet de notes dont vous ne lisez qu’un résumé
Retenir votre métier ou votre goût pour les réponses courtes vous évite de répéter vos consignes. Sympathique. Sauf que, d’après la FAQ mémoire d’OpenAI, le résumé affiché ne reprend pas tout ce que ChatGPT retient de vos échanges, que des informations sensibles peuvent s’y glisser si vous les partagez, et que réactiver la mémoire peut recréer des souvenirs à partir d’anciennes conversations toujours présentes dans l’historique.
Pour effacer vraiment une information, il faut donc la traquer partout où elle apparaît : le souvenir, la conversation d’origine, les fichiers, les applications connectées. Supprimer la seule ligne du résumé, c’est ranger le tiroir visible et laisser le garage en l’état.
L’entraînement : une case à cocher, pas un interrupteur général
Chez OpenAI, l’option « Améliorer le modèle pour tous » se règle dans les contrôles de données et concerne les nouvelles conversations. Elle gouverne la réutilisation de vos contenus, pas l’existence de votre historique ni celle de votre mémoire. Les chats temporaires, eux, ne servent pas à améliorer les modèles tant qu’ils restent temporaires.
D’où trois questions à poser séparément, parce qu’un seul bouton n’y répond jamais :
- Voulez-vous garder cette conversation dans votre compte ?
- Voulez-vous qu’elle serve à personnaliser les réponses futures ?
- Autorisez-vous son utilisation pour améliorer les modèles ?
Perplexity : pourquoi la réponse honnête est « oui, potentiellement »
Allons droit au but, puisque c’est la question qui nous a amenés ici. D’après la page d’aide « Data collection at Perplexity », les comptes Free, Pro et Max ont le paramètre « AI data retention » activé par défaut, et tant qu’il l’est, vos données peuvent contribuer à l’entraînement. Les comptes Enterprise sont exclus : leurs données ne servent jamais à entraîner les modèles.
Deuxième détail qui change tout : le refus ne vaut que pour la suite. Ce qui a déjà été collecté ne ressort pas du jeu de données. Un guide de DeleteMe et l’analyse d’Anonyome le rappellent aussi, tout comme le fait que refuser l’entraînement n’empêche pas les traitements nécessaires au fonctionnement et à la sécurité du service.
Ce que personne ne peut vous dire
ChatGPT et Perplexity côte à côte : le tableau qui évite les malentendus
| Critère | ChatGPT | Perplexity |
|---|---|---|
| Où se règle l’entraînement ? | Paramètres → Contrôles des données → « Améliorer le modèle pour tous » | Paramètres → « AI data retention » |
| Portée du refus | S’applique aux nouvelles conversations | Uniquement aux données collectées après le refus : rien n’est rétroactif |
| Entraînement activé par défaut (comptes grand public) | À vérifier dans vos propres réglages : ne le supposez pas | Oui, sur Free, Pro et Max |
| Mode « sans trace » | Chat temporaire : hors historique, hors entraînement, copie de sécurité jusqu’à 30 jours | Mode incognito signalé par des analyses tierces : lisez sa fiche d’aide avant d’y croire |
| Offres entreprise | Team, Enterprise et Edu : contrôles de données supplémentaires | Enterprise : jamais utilisé pour l’entraînement |
Secret professionnel : votre IA ne porte pas de robe d’avocat
Un assistant peut expliquer une procédure ou vous aider à préparer vos questions pour un conseil. Ça ne transforme pas la conversation en échange protégé. Une affaire américaine, très commentée, l’illustre sans fioritures.
Étude de cas · États-Unis
United States v. Heppner (février 2026)
Bradley Heppner, poursuivi pour fraude, avait utilisé Claude (d’Anthropic) pour préparer des documents liés à sa défense. Les enquêteurs ont saisi des appareils contenant environ 31 documents issus de ces échanges. Le juge Jed Rakoff a tranché de vive voix le 10 février 2026, puis publié une opinion écrite le 17 février : ni secret avocat-client, ni protection des documents préparatoires au procès.
Les motifs : un outil d’IA n’est pas un avocat, les échanges ont été confiés à une plateforme tierce, et Heppner avait agi de sa propre initiative, pas sur instruction de son conseil. Lire le détail chez Orrick, Proskauer ou dans l’analyse de l’ISBA.
À retenir : l’outil en cause était Claude, mais ce n’est pas une affaire de marque, c’est une affaire de statut juridique. Un chatbot n’est pas tenu à votre confidentialité professionnelle.
Pas de panique collective pour autant. Venable rappelle que la décision ne crée pas d’exception propre à l’IA : elle applique des principes classiques à des faits précis (usage autonome, plateforme publique). Les circonstances, le contrat, le déploiement et l’intervention d’un avocat comptent. Et le droit français a ses propres règles. Reste le réflexe utile : ne confiez pas à un outil grand public ce que vous n’oseriez pas poser sur la table d’un tiers.
Supprimer, c’est presque effacer
Chez OpenAI, une conversation supprimée disparaît tout de suite de votre compte, puis sa suppression définitive est programmée sous 30 jours, sauf données déjà dissociées de vous ou obligation de sécurité ou légale. Un chat temporaire n’apparaît pas dans l’historique, mais une copie peut être gardée jusqu’à 30 jours pour la sécurité.
Étude de cas · Justice
Le New York Times, OpenAI et l’ordonnance de conservation
Le 13 mai 2025, un tribunal new-yorkais a ordonné à OpenAI de conserver des journaux de sorties qui auraient dû être supprimés, y compris à la demande des utilisateurs. L’obligation générale a pris fin le 26 septembre 2025, mais les données déjà mises de côté restent conservées, hors requêtes émises depuis l’EEE, la Suisse et le Royaume-Uni. Sources : la stipulation du tribunal, l’analyse de Duane Morris et Engadget.
À retenir : une règle d’effacement a des exceptions. Ce n’est pas « tout est gardé pour toujours », c’est « le périmètre se vérifie ».
La publicité s’invite dans la conversation (poliment, avec une étiquette)
OpenAI a lancé ses tests publicitaires dans ChatGPT en février 2026 aux États-Unis. Puis l’entreprise a annoncé l’extension à 31 marchés européens, France comprise, pour les offres Free et Go. Côté vie privée, la page d’aide sur les publicités pose les règles : les conversations ne sont pas partagées avec les annonceurs, les données ne sont pas vendues, et, quand la personnalisation est activée, les annonces peuvent s’appuyer sur vos chats et sur la mémoire.
Deux nuances à garder en tête. D’abord, choisir une annonce à partir de votre contexte n’équivaut pas à la livrer à l’annonceur avec votre prénom. Ensuite, disponibilité et personnalisation sont deux choses : selon la presse spécialisée, les publicités personnalisées ne sont pas proposées d’emblée dans l’Espace économique européen et en Suisse. Les chats temporaires en sont exclus. Votre question sur un tapis de course et la pub pour un tapis de course n’ont donc, officiellement, rien à voir. Elles ont simplement beaucoup en commun.
Fuites et faillites : quand le risque vient d’ailleurs que de votre réglage
Muah.AI : votre adresse e-mail et votre confidence, dans le même fichier
En septembre 2024, le service de compagnons IA Muah.AI a été piraté. Selon Have I Been Pwned, 1,9 million d’adresses e-mail ont été exposées avec des prompts. La fuite est classée sensible : seul le propriétaire vérifié d’une adresse peut y chercher la sienne. La fiche de Mozilla Monitor la recense également, et CyberInsider détaille l’affaire à partir des révélations de 404 Media.
La leçon n’est pas que tous les assistants fuient. C’est qu’un service présenté comme intime reste un système informatique, et qu’une adresse e-mail associée à une confidence suffit à identifier quelqu’un.
Character.AI : qui hérite des conversations quand la boîte plie ?
Étude de cas · Faillite
Character.AI et le Chapter 11 (12 octobre 2026)
Character Technologies, l’éditeur de Character.AI, a demandé la protection du Chapter 11 américain le 12 octobre 2026. Disney propose 20 millions de dollars comme « stalking horse » pour une licence perpétuelle non exclusive sur certains actifs de propriété intellectuelle, selon Betanews et Implicator. D’après PPC Land, la licence exclut l’application, la marque, les domaines, les données utilisateurs et les chats.
Pour autant, tout n’est pas réglé : eMarketer indique que l’application, les données et les conversations restent proposées à la vente, et la politique de confidentialité autorise la divulgation des données en cas de cession (The Cool Down). Un décryptage des pièces judiciaires note que le sort des données n’est pas tranché publiquement. Les utilisateurs peuvent exporter leurs données ou fermer leur compte.
À retenir : non, Disney n’a pas « acheté vos conversations ». Mais vos engagements de confidentialité valent aussi le jour du rachat, de la revente ou de la fermeture.
Le contrôle technique de vos réglages (15 minutes, un café)
Les intitulés changent selon la version et le type de compte. Cherchez ces contrôles, pas ces libellés au caractère près.
Dans ChatGPT
- Mémoire : ouvrez Paramètres → Personnalisation → Mémoire, relisez, corrigez, supprimez. Pensez aux conversations d’origine.
- Entraînement : Paramètres → Contrôles des données → désactivez « Améliorer le modèle pour tous » (mode d’emploi OpenAI).
- Sujets sensibles : lancez un chat temporaire avant de commencer, et gardez en tête la copie de sécurité jusqu’à 30 jours.
- Publicités : si elles sont disponibles sur votre compte, vérifiez les réglages de personnalisation.
Dans Perplexity
- Entraînement : Paramètres → désactivez « AI data retention », en sachant que cela ne vaut que pour l’avenir.
- Historique : supprimez les fils que vous ne voulez plus voir dans votre bibliothèque.
- Mémoire : consultez la section dédiée des paramètres si elle apparaît sur votre compte.
PME : les réglages individuels ne font pas une politique d’entreprise
Quand la dirigeante colle un contrat client dans un outil grand public, elle n’expose pas que ses propres confidences, mais celles du client, du salarié et du partenaire. Régler son compte ne règle pas ça.
La CNIL insiste sur une démarche simple dans ses questions-réponses sur l’IA générative et sa page « Comment déployer une IA générative ? » : partir d’un besoin concret, choisir un déploiement sécurisé (en privilégiant, quand c’est possible, des systèmes locaux, sécurisés et spécialisés) et, à défaut, mesurer dans quelle mesure le prestataire peut réutiliser les données saisies, puis adapter l’usage en conséquence. Pour les TPE et PME, la CNIL renvoie aussi à des fiches pratiques France Num.
Le principe de minimisation, version terrain : donner à l’IA ce dont elle a besoin pour répondre, pas ce dont vous disposez.
- Définir les usages qui apportent une valeur réelle.
- Lister les données nécessaires, et celles qui restent exclues (noms de clients, santé, RH, secrets commerciaux).
- Lire le contrat : conservation, réutilisation, offre professionnelle ou grand public.
- Limiter les accès et les connexions aux autres outils.
- Former les équipes et prévoir quoi faire quand quelqu’un colle ce qu’il ne fallait pas.
C’est ce cadrage que nous traitons chez DeepDive : André Gentit, activateur France Num, accompagne dirigeants et équipes pour transformer des usages de l’IA bricolés en pratiques écrites, comprises et tenables. Sans interdire l’outil, ce qui reste la meilleure façon de le voir contourné.
Questions qu’on nous pose vraiment
Perplexity entraîne-t-il ses modèles sur mes conversations ?
Potentiellement, oui. Selon l’aide officielle de Perplexity, le paramètre « AI data retention » est activé par défaut sur les comptes Free, Pro et Max, et les données collectées servent alors à l’entraînement. Les comptes Enterprise sont exclus. Le refus ne vaut que pour les données collectées après sa désactivation. Personne, hors de Perplexity, ne peut vous dire si telle conversation précise a servi.
Désactiver l’entraînement supprime-t-il mon historique ou ma mémoire ?
Non. Ce sont des réglages indépendants. Refuser l’entraînement n’efface pas vos discussions, et couper la mémoire ne supprime pas l’historique. Pour retirer une information, il faut la supprimer partout où elle apparaît : souvenir enregistré, conversation d’origine, fichiers, applications connectées.
Ma conversation avec une IA est-elle protégée par le secret professionnel ?
Non, pas automatiquement. Dans l’affaire américaine United States v. Heppner, un juge fédéral a refusé de protéger des documents générés avec un chatbot grand public. La décision est américaine et tient aux circonstances, mais elle rappelle qu’un outil capable de parler droit n’est pas un avocat tenu à votre confidentialité.
Les annonceurs voient-ils mes conversations avec ChatGPT ?
OpenAI affirme que non : les annonceurs ne reçoivent pas les conversations et la société déclare ne jamais vendre les données. Les publicités peuvent en revanche s’appuyer sur le contexte de la discussion et, là où la personnalisation est disponible, sur la mémoire. En Europe, les annonces ont été lancées en contextuel, sans personnalisation au départ.
Que doit contenir une politique d’usage de l’IA en PME ?
Les usages autorisés et interdits, les catégories de données à ne jamais saisir, le choix des outils et de leurs offres professionnelles, la vérification des contrats (conservation, réutilisation), la gestion des accès, la formation des équipes et une procédure en cas de partage accidentel. Le tout en cohérence avec les recommandations de la CNIL.
Conclusion : personnaliser n’oblige pas à tout confier
Le point de vue de DeepDive
Pour ouvrir le sujet : si le contexte personnel est ce qui rend ces outils utiles, et ce qui les rend risqués, la vraie bataille des prochains mois portera sur qui le garde. Modèles locaux, offres professionnelles, contrats négociés : la confidentialité deviendra une fonctionnalité qu’on achète ou qu’on paramètre. Reste à savoir si votre entreprise sera prête le jour où on lui posera la question.
Envie de passer vos usages de l’IA au crible, réglages et politique interne compris ? C’est précisément ce que DeepDive met en place, en formation comme en conseil.
Sources principales
- OpenAI · Memory FAQ
- OpenAI · Data controls FAQ
- OpenAI · How your data is used to improve model performance
- OpenAI · Chat and file retention policies
- OpenAI · Temporary Chat FAQ
- OpenAI · Ads in ChatGPT
- OpenAI · ChatGPT Ads expands across Europe
- Perplexity · Data collection at Perplexity
- Orrick · United States v. Heppner
- Proskauer · Heppner
- Venable · Heppner
- ISBA · Heppner and the AI privilege problem
- Duane Morris · OpenAI preservation orders
- Have I Been Pwned · Muah.AI
- PPC Land · Disney et Character.AI
- CNIL · Questions-réponses IA générative
- CNIL · Comment déployer une IA générative ?

André Gentit Formateur & Consultant en Stratégie Web et IA générative
Vous souhaitez bâtir une stratégie de communication efficace, booster la performance de votre site internet ou mieux comprendre les dynamiques des réseaux sociaux ?
👉 Avec DeepDive, je vous accompagne grâce à une expertise terrain (ex-dirigeant d’agence digitale depuis 2011) et une veille continue sur les nouvelles pratiques numériques.
👉 J’interviens auprès de TPE, PME et collectivités, mais aussi en écoles et organismes (CNAM, CCI, écoles de commerce) pour rendre le numérique accessible et opérationnel.
👉 Mes formations couvrent le webmarketing, l’e-commerce, l’IA générative appliquée et incluent également une sensibilisation aux risques liés aux usages du web en général, sans oublier les bonnes pratiques à mettre en œuvre avec l’intelligence artificielle.
Mon objectif : transmettre des savoirs concrets pour que chaque apprenant — étudiant, salarié, entrepreneur ou institution — puisse transformer le numérique et l’IA en véritable levier de réussite.
Découvrez mon petit robot PromptyBot qui vous propose des centaines de prompts optimisés